4款本地大模型实测:双5070 Ti跑出160 tok/s,谁才是性价比之王?
测试背景
手头有一台 2×RTX 5070 Ti(32GB 显存)的机器,本地装了 4 个开源大模型:
| 模型 | 参数量 | 架构 | 量化 | 大小 |
|---|---|---|---|---|
| gemma4-12B | 12B | Dense | Q8_0 | 12GB |
| gemma4-26B | 26B (4B active) | MoE | Q4_K_XL | 15GB |
| Qwen3.5-27B | 27B | Dense | AWQ | 21GB |
| Qwen3.5-9B | 9B | Dense | FP16 | 19GB |
同一个硬件,同一套测试题,7 个维度全面对比——跑完才发现,差距比想象中大得多。
测试维度与方法
设计了 7 个测试项,覆盖实际使用场景:
短文生成 TTFT(首字延迟)——体感响应速度
长上下文 TTFT(2245 token 输入)——满上下文场景
编程实现——LRU Cache,考察算法理解 + 代码质量
编程调试——给一段有 bug 的合并排序代码,找错修复
工具调用——function calling 能力
中文理解——碳达峰/碳中和政策阅读理解
指令遵从——严格按格式输出,不多不少
通过 ollama 原生 API 和 vLLM OpenAI API 获取精确的 eval_count 和 eval_duration,不靠数字符估算。
核心数据:速度对比
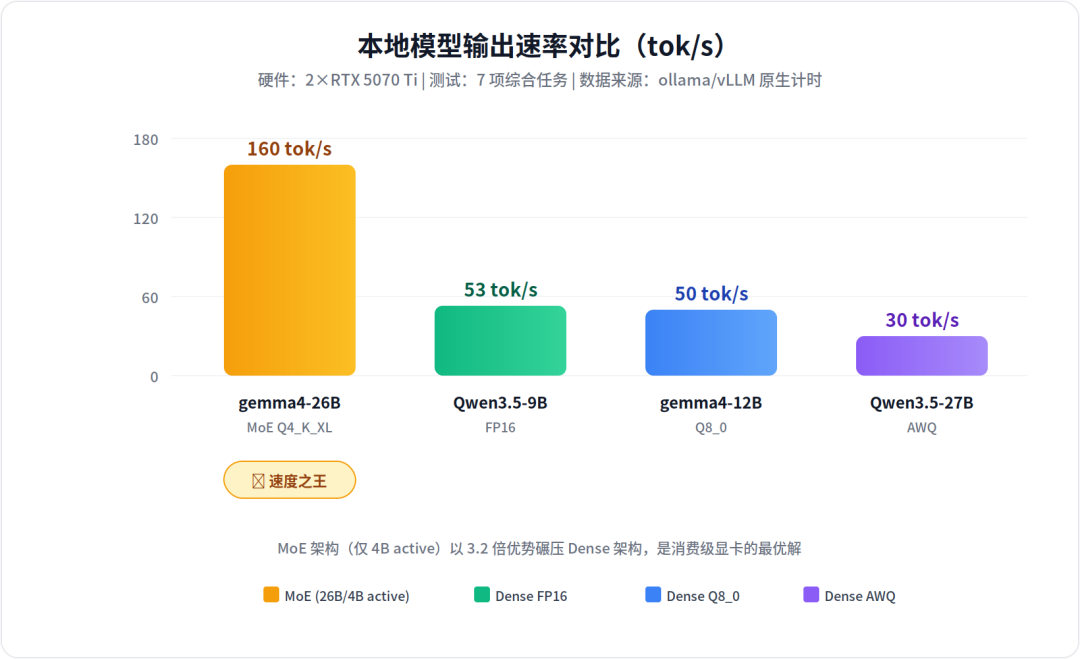
这张图说明一切:
gemma4-26B 以 160 tok/s 碾压全场,是第二名的 3 倍。
原因很简单:gemma4-26B 虽然总参数量 26B,但它是 MoE(混合专家)架构,每次推理只激活 4B 参数。12B 的计算量,26B 的知识量——这就是 MoE 的威力。
完整速度数据:
| 指标 | gemma4-12B | gemma4-26B | Qwen3.5-27B | Qwen3.5-9B |
|---|---|---|---|---|
| 输出速率 | 50 tok/s | 160 tok/s | 30 tok/s | 53 tok/s |
| 短文首字延迟 | 35ms | 34ms | 151ms | 37ms |
| 长上下文首字延迟 | 62ms | 537ms | 1.6s | 527ms |
| 冷启动延迟 | 无 | 无 | 无 | ~20s |
几个有意思的发现:
gemma 系列首字延迟极低(35ms),Qwen 系列明显慢一拍
Qwen3.5-9B 有 20 秒冷启动,第一次请求要等模型加载,后续才正常
Qwen3.5-27B 最慢,27B dense 架构计算量大,AWQ 量化也救不了
能力对比:编程、工具调用、中文理解
速度只是一方面,能力同样重要。
编程能力:4 模型全部通过
LRU Cache 实现和代码调试两个测试,4 个模型都给出了正确的实现和准确的 bug 分析。
不过细节有差异:
gemma 系列:代码直接给,干净利落
Qwen 系列:先输出一段”Thinking Process”思维链,再给代码——更透明,但 token 消耗更多
工具调用:gemma 完胜
| 模型 | 工具调用 | 说明 |
|---|---|---|
| gemma4-12B | ✅ | 正确调用 get_weather(city="北京") |
| gemma4-26B | ✅ | 同样正确,速度更快 |
| Qwen3.5-27B | ❌ | vLLM 返回 400 错误 |
| Qwen3.5-9B | ❌ | 同上 |
这是部署方式造成的差异,不完全是模型本身的差距。ollama 原生支持 function calling,而 vLLM 0.22.0 的工具调用兼容性还有问题。
如果你的场景依赖工具调用(Agent、自动化流程),gemma + ollama 是当前最稳的组合。
中文理解与指令遵从:4 模型差距不大
碳达峰/碳中和政策理解题,4 个模型都答对了三个问题。指令遵从测试也都能按格式输出。
Qwen 系列的优势在思维链——它会把推理过程展示出来,适合需要”可解释性”的场景。
综合评分
| 维度 | gemma4-12B | gemma4-26B | Qwen3.5-27B | Qwen3.5-9B |
|---|---|---|---|---|
| 输出速度 | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐ |
| 首字延迟 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐ |
| 编程能力 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 工具调用 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐ | ⭐⭐ |
| 中文理解 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 思维链 | ⭐⭐ | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| GPU 效率 | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐⭐ |
结论:不同场景怎么选
日常开发 / Agent 工具调用 → gemma4-26B
160 tok/s 的速度意味着几乎无感的等待,工具调用稳定可靠。MoE 架构用 4B 的计算量承载 26B 的知识,这是目前本地部署的最优解。
高质量推理 / 代码审查 → Qwen3.5-9B
FP16 无量化损失,思维链输出更透明。53 tok/s 的速度也够用。适合对质量要求高、不太在意冷启动的场景。
轻量级任务 / 显存紧张 → gemma4-12B
12GB 占用最低,50 tok/s 均衡稳定。如果只有一张卡,这是最务实的选择。
不推荐:Qwen3.5-27B AWQ
速度最慢(30 tok/s)、显存最大(28GB)、工具调用不支持。27B dense 架构在消费级显卡上性价比太低。
最后说两句
这次测试最大的收获是:MoE 架构在消费级显卡上的优势是碾压性的。
gemma4-26B 用 4B active 参数跑出了 160 tok/s,而 12B dense 只有 50 tok/s。同样是”塞进 32GB 显存”,MoE 能同时兼顾速度和知识量,dense 做不到。
如果你正在纠结本地部署哪个模型,我的建议是:先试 MoE。
测试环境:2×RTX 5070 Ti 16GB | Ollama + vLLM 0.22.0 | 2026-06-27