视频理解不需要大模型!2B参数的Marlin-2B就能胜任
“2B 参数,单张消费级显卡跑,密集字幕打平大模型,时间定位超越7B——这不是魔法,这是 NemoStation 的 Marlin-2B。”
一、它解决什么问题
视频理解,是大模型的天下。
GPT、Gemini、Claude——这些模型在视频任务上确实强,但强是有代价的:参数量巨大,推理成本高,部署门槛高,普通开发者根本用不起。
更关键的是,大多数通用大模型做视频理解,是”通用”的——你让它分析一段视频,它给你一段综述,但你想问的是”第几秒发生了什么”,它往往给不出精确答案。
Marlin-2B 的出发点很直接:不要通用,只要精确。
它只回答两个问题:
What — 视频里正在发生什么?(结构化的场景 + 事件描述)
When — 这件事发生在第几秒?(秒级精确的时间定位)
围绕这两个核心问题,Marlin-2B 把每一项能力都调到了 2B 参数级别的极致。
二、核心能力:两种模式
Marlin-2B 暴露两个接口,对应两种核心能力:
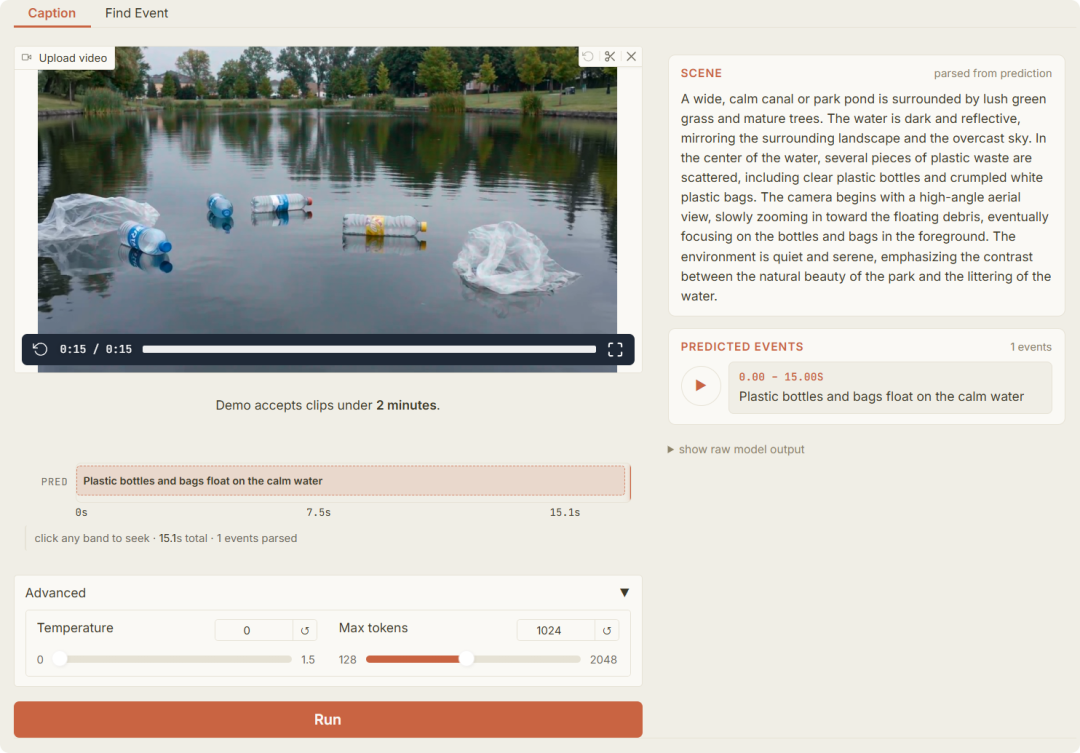
caption 模式:密集字幕
输入一段视频,输出结构化的场景描述 + 带秒级时间戳的事件列表。
from marlin import MarlinRunner runner = MarlinRunner.from_pretrained("NemoStation/Marlin-2B") result = runner.caption( video_path="input.mp4", prompt="详细描述这个视频里发生的事情" ) # 输出: {scenes: [...], events: [{start: 1.0, end: 3.5, description: "..."}]}
不是给一段话,而是给你一个带时间戳的事件清单。你可以把它理解为——视频的结构化索引。
find 模式:时间定位
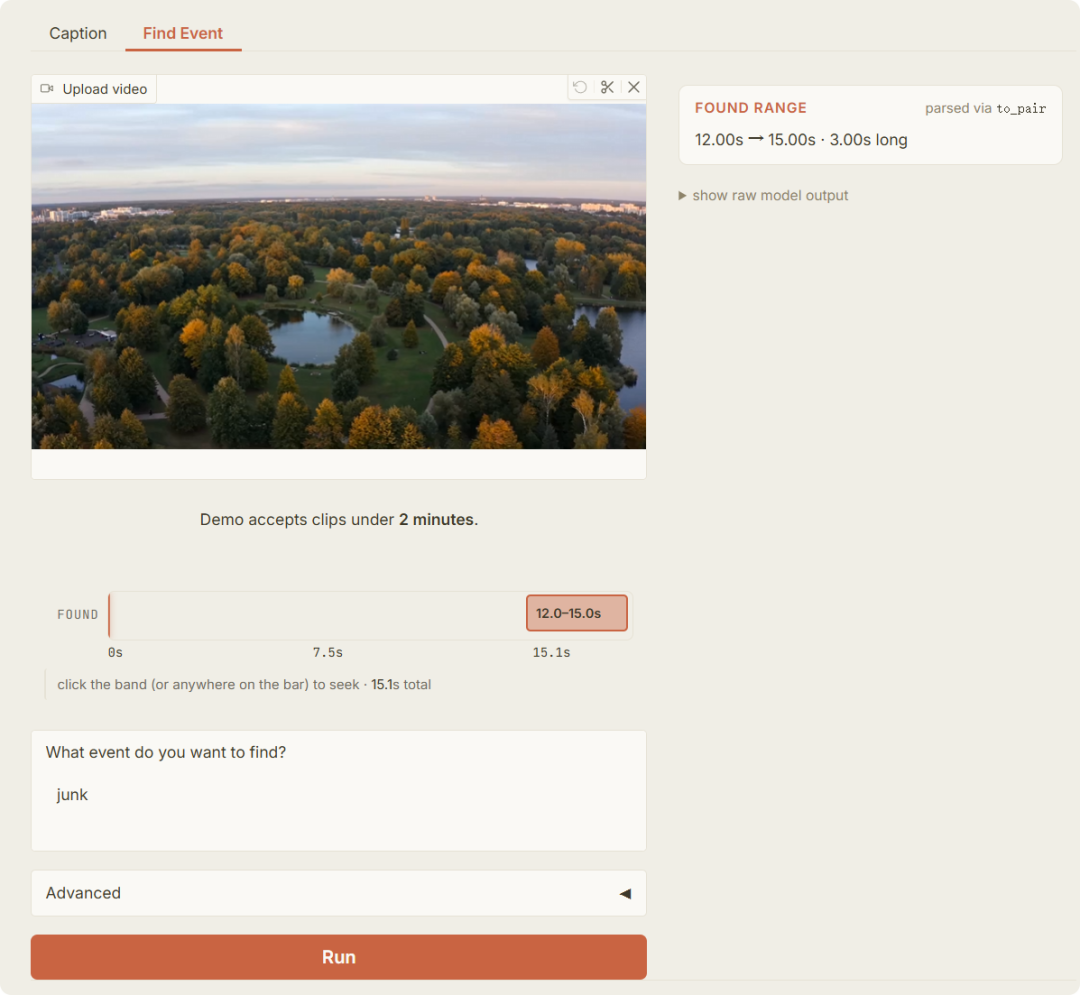
用自然语言问一个问题,模型返回事件发生的时间段。
result = runner.find( video_path="input.mp4", query="这个人什么时候开始跑步的?" ) # 输出: {spans: [{start: 12.0, end: 18.5, reason: "..."}]}
问”什么时候”,它给你精确的起止时间戳。这就是”时间 grounding”——把自然语言 query 映射到视频里的时间区间。
三、硬核数据:打平还是超越
光吹不行,看数据。
Marlin-2B 官方在三个主流基准上做了评测:
|
基准
|
任务
|
Marlin-2B 成绩
|
对比
|
| — | — | — | — |
| CaReBench |
密集字幕
|
开源第一
|
首个开源且效果领先
|
| DREAM-1K |
密集字幕
|
同量级最强
|
2B 级别最强
|
| TimeLens-Bench |
时间定位
|
超越 7B 模型
|
打平 Gemini-2.5 Flash
|
关键结论:同参数级别最强,开源社区同量级无对手,时间定位甚至超越了参数量更大的模型。
成本呢?单张消费级显卡(建议 8GB+ VRAM)直接跑。
四、技术架构:为什么2B能打这么狠
Marlin-2B 之所以能在 2B 量级打出这种效果,背后的设计思路值得关注:
基座:Qwen3.5-2B 基于 Qwen3.5-2B 基座模型,Qwen 家族在多模态上的早熟积累直接受益。
训练范式:两阶段 SFT + SimPO
SFT(监督微调):先让模型学会正确的输出格式和结构
SimPO(Simple Preference Optimization):在高质量视频数据上做偏好优化,强化”答对问题”的能力
输入处理:2 FPS 采样 视频以每秒 2 帧的频率采样,最多处理 240 帧(约 2 分钟)。这个采样率在保证信息密度的同时控制了计算量,让 2B 模型也能处理长视频。
输出设计:结构化而非文本 通过 modeling_marlin.py 里的自定义建模代码,强制模型输出 {scenes, events} 或 {spans} 这样的结构化字典,不是自由的文本描述——这直接提升了时间定位的准确性。
五、局限性
说完了好,也要说清楚它的局限:
视频时长:最多 240 帧(约 2 分钟),长视频需要先切分再拼接
帧率固定:2 FPS,不适合需要亚秒级精度的场景
VRAM 要求:推理需要约 8GB+ 显存
多模态理解:侧重时间定位和结构化输出,开放式视频问答不是它的强项
它的定位从一开始就不是”通用视频理解”,而是”精准的结构化输出”。在这个定位下,它的性价比极高。
六、安装和使用:两行代码跑起来
环境依赖
pip install torch transformers accelerate
模型加载(HuggingFace)
from transformers import AutoModelForCausalLM, AutoProcessor from marlin.marlin_runner import MarlinRunner runner = MarlinRunner.from_pretrained("NemoStation/Marlin-2B")
密集字幕任务
result = runner.caption( video_path="your_video.mp4", prompt="详细描述这个视频的所有事件" ) for event in result["events"]: print(f"{event['start']:.1f}s - {event['end']:.1f}s: {event['description']}")
时间定位任务
result = runner.find( video_path="your_video.mp4", query="目标人物出现在画面的时间段是?" ) for span in result["spans"]: print(f"{span['start']:.1f}s - {span['end']:.1f}s: {span['reason']}")
国内镜像(ModelScope)
runner = MarlinRunner.from_pretrained("NemoStation/Marlin-2B", hub="modelscope")
七、适合谁用
Marlin-2B 不是一个”全能选手”,但它在特定场景下极其好用:
视频内容分析平台:需要提取视频结构化标签,而不是自由文本描述
安防/工业检测:需要知道”第几秒发生了什么”,精确时间戳是刚需
视频数据标注工具:用 find 模式做时间定位标注,效率远超人工
长视频检索:用 caption 建立索引,自然语言直接搜视频内容
端侧视频理解:2B 够小,消费级显卡跑得动,适合私有化部署
八、为什么它值得关注
大模型时代有一个趋势:”越大越好”。参数越大、能力越强——这个逻辑在通用任务上成立,但在垂直任务上未必。
Marlin-2B 证明了一件事:当你把问题收窄到”精确的结构化输出”,2B 参数可以做得比百亿模型更准、更快、更便宜。
它不是大模型的替代者。它是大模型在特定场景下的高效替代方案。
当你的需求是”告诉我第几秒发生了什么”,而不是”给这段视频写一段解说词”——Marlin-2B 可能是你见过最高性价比的选择。
项目地址
HuggingFace:https://huggingface.co/NemoStation/Marlin-2B
许可:Apache 2.0,商用无门槛